Vibe Coding verändert die Softwareentwicklung. Mit Tools wie Lovable, Cursor, Claude Code, Bolt oder Replit lassen sich heute in kurzer Zeit komplette Anwendungen entwickeln. Von der ersten Idee bis zur produktiven SaaS-Anwendung in wenigen Tagen oder Wochen.
Das ist eine enorme Chance. Gleichzeitig verschiebt sich die Verantwortung für Security nicht auf das AI-Tool. Denn auch wenn ein AI-Agent große Teile des Codes schreibt, bleibt die entscheidende Frage:
Wer stellt sicher, dass die Anwendung dauerhaft sicher bleibt?
Gerade bei Vibe Coding und Agentic Coding entsteht Security deshalb nicht erst beim abschließenden Pentest. Sie beginnt bei den Prompts, setzt sich über Code und Dependencies fort und reicht bis zu CI/CD, Deployment und Patch Management.
Was ist Vibe Coding?
Beim Vibe Coding beschreibt der Entwickler einer AI möglichst natürlich, was die Anwendung tun soll. Der AI-Agent erzeugt daraus Code, Datenmodelle, API-Endpunkte, UI-Komponenten oder ganze Features.
Das ermöglicht es auch Entwicklern mit begrenzter Erfahrung in einzelnen Technologien, schnell funktionierende Anwendungen zu bauen. Der erzeugte Programmcode wird dabei häufig nur oberflächlich oder überhaupt nicht manuell geprüft. Das kann unterschiedliche Gründe haben. Zum Beispiel fehlendes Detailverständnis des generierten Codes, die hohe Geschwindigkeit der Entwicklung oder schlicht Zeitersparnis. Gerade bei größeren Projekten kann es dadurch schwierig werden, jederzeit zu wissen, welche Sicherheitsmechanismen tatsächlich implementiert sind und welche Annahmen der AI-Agent bei der Entwicklung getroffen hat.
Fertige Frameworks, etablierte Authentifizierungsbibliotheken und Datenbankplattformen bieten dabei wichtige Security-relevante Einstellungen und Rahmenbedingungen. So die Hoffnung.
Aber ein Framework kann nur einen Teil der Security sicherstellen.
Wie sicher die fertige Anwendung ist, hängt unter anderem davon ab,
- welche Anforderungen der Entwickler formuliert,
- welche Architektur der AI-Agent daraus erzeugt,
- welche Security Controls tatsächlich implementiert werden,
- welche Libraries und Plugins verwendet werden,
- wie Berechtigungen umgesetzt werden,
- wie Änderungen getestet werden und
- wie schnell Sicherheitsupdates in Produktion gelangen.
Der Vibe Coder trägt damit weiterhin Verantwortung für den eigenen Code. Auch dann, wenn diesen Code überwiegend eine AI geschrieben hat.
Vibe Coding Security: Wo entstehen die Risiken?
Ein häufiges Missverständnis lautet:
„Wenn der Code funktioniert, wird er schon sicher sein.“
Das ist leider nicht der Fall. AI-generierter Code kann technisch korrekt funktionieren und gleichzeitig gravierende Sicherheitsprobleme enthalten.
Besonders kritisch wird es, wenn ein Projekt schnell wächst. Aus einer kleinen Anwendung mit wenigen Komponenten wird innerhalb kurzer Zeit ein komplexes System mit Authentifizierung, APIs, Datenbank, Datei-Uploads, Bezahlfunktionen, Drittanbieter-Integrationen und mehreren Benutzerrollen.
Mit jeder zusätzlichen Funktion steigt nicht nur die Menge des eigenen Codes. Es steigt auch die Zahl der Abhängigkeiten und Potenziale für Bugs und Schwachstellen.
AI-generierter Code kann funktionieren und trotzdem unsicher sein
Nehmen wir einen scheinbar völlig harmlosen Prompt:
„Füge einen Datei-Upload für PDF- und Bilddateien hinzu und speichere die Dateien in Supabase Storage.“
Der AI-Agent kann daraus problemlos eine funktionierende Upload-Funktion bauen.
Aber was bedeutet „sicherer Datei-Upload“?
Zum Beispiel:
- Wird die tatsächliche Dateiendung geprüft oder nur der vom Browser gelieferte Content-Type?
- Gibt es Größenlimits?
- Können Benutzer Dateien anderer Benutzer herunterladen?
- Sind die Storage-Buckets korrekt abgesichert?
- Sind direkte URLs geschützt?
- Können Dateinamen oder Pfade manipuliert werden?
- Werden gefährliche Dateitypen ausgeschlossen?
- Werden hochgeladene Dateien serverseitig validiert?
- Können Dateien über andere API-Endpunkte erreicht werden?
- Wo werden Dateien serverseitig abgespeichert? Im öffentlichen Web-Root-Verzeichnis oder an einem internen Pfad?
- Welche Dateiberechtigungen werden standardmäßig vergeben?
Der ursprüngliche Prompt war nicht falsch.
Er war nur nicht präzise genug, um Security-Anforderungen festzulegen.
Das Gleiche gilt für RBAC
Ein anderer typischer Prompt könnte lauten:
„Füge meiner SaaS-Anwendung die Rollen Admin, Manager und User hinzu. Admins können alles verwalten, Manager können Projekte verwalten und normale User können nur ihre eigenen Projekte sehen.“
Auch das klingt völlig plausibel.
Die Anwendung kann danach perfekt funktionieren. Im Frontend sieht jeder Benutzer genau die Buttons, die zu seiner Rolle passen. Nicht mehr, nicht weniger.
Aber entscheidend ist nicht, was das Frontend anzeigt.
Entscheidend ist, was die API akzeptiert.
Wenn ein Benutzer beispielsweise auf /api/projects/123 zugreifen darf, muss serverseitig geprüft werden, ob er tatsächlich berechtigt ist, genau dieses Projekt zu sehen.
Ein Angreifer sollte nicht einfach eine andere Projekt-ID verwenden können, um Daten eines anderen Benutzers oder Tenants abzurufen. Das sind typische Problemfelder rund um Broken Access Control, BOLA und IDOR.
Der Prompt entscheidet mit über die Security
Je konkreter Security-Anforderungen im Entwicklungsprozess formuliert werden, desto besser kann ein AI-Agent sie berücksichtigen.
Zum Beispiel:
„Implementiere serverseitige Autorisierung für jeden Projektzugriff. Ein authentifizierter Benutzer darf ausschließlich Projekte seines eigenen Tenants lesen und verändern. Verlasse dich niemals auf vom Client übermittelte User- oder Tenant-IDs. Prüfe die Berechtigung vor jeder Datenrückgabe und jedem Schreibzugriff. Ergänze Tests für horizontale Privilegieneskalation und direkte API-Aufrufe.“
Das macht aus einer allgemeinen Feature-Anforderung eine Anforderung mit konkreten Security Controls.
Trotzdem sollte man dem generierten Ergebnis nicht blind vertrauen.
Denn auch ein sehr guter Prompt garantiert nicht, dass der resultierende Code sicher ist.
Die wichtigsten Prüfbereiche einer AI-generierten Anwendung
Bei einem AI Application Pentest können unter anderem folgende Bereiche relevant sein:
| Bereich | Typische Fragestellung |
|---|---|
| Authentication | Kann die Authentifizierung umgangen werden? |
| Authorization | Werden Berechtigungen serverseitig korrekt geprüft? |
| RBAC | Können Benutzer ihre Rolle oder Rechte umgehen? |
| API Security | Sind API-Endpunkte ausreichend geschützt? |
| BOLA / IDOR | Kann auf fremde Objekte zugegriffen werden? |
| Tenant Isolation | Sind Kundendaten und Mandaten sauber voneinander getrennt? |
| File Upload | Sind Uploads ausreichend validiert und geschützt? |
| Input Validation | Können manipulierte Eingaben verarbeitet werden? |
| Injection | Sind Datenbank- und andere Schnittstellen ausreichend geschützt? |
| Business Logic | Lassen sich Prozesse missbrauchen? |
| Secrets | Werden Credentials oder API Keys sicher behandelt? |
| Database Security | Sind Datenzugriffe und Policies korrekt umgesetzt? |
| Session Security | Sind Sessions und Tokens ausreichend geschützt? |
Agentic Coding und Security Regression
Ein besonders interessantes Problem entsteht durch Agentic Coding.
Ein AI-Agent entwickelt eine Anwendung nicht unbedingt linear.
Stattdessen arbeitet er über längere Zeit an einem Projekt:
- Feature implementieren
- Bug beheben
- Datenmodell ändern
- UI erweitern
- API anpassen
- neues Plugin hinzufügen
- Authentifizierung verändern
- weitere Funktion implementieren
Das Problem:
Jede Änderung kann bestehende Security Controls beeinflussen.
Angenommen, eine API wurde ursprünglich korrekt auf Tenant-Isolation geprüft.
Einige Tage später bittet der Entwickler den Agenten:
„Optimiere den Projekt-Endpunkt und vereinfache die Abfrage.“
Der Agent verändert daraufhin möglicherweise nicht nur die gewünschte Query, sondern auch angrenzende Logik.
Die Anwendung funktioniert weiterhin.
Aber wurde die ursprüngliche Autorisierungsprüfung tatsächlich beibehalten? Oder wurde sie verändert?
Und falls sie verändert wurde: Ist sie noch korrekt?
Genau hier entstehen Security Regression Bugs.
Je länger ein Agent an einem Projekt arbeitet und je größer das Projekt wird, desto schwieriger wird es für den Entwickler, jede einzelne Änderung hinsichtlich Security vollständig nachzuvollziehen.
Nicht nur dein Code ist dein Problem: Dependencies und Plugins
Ein weiterer Punkt wird beim Vibe Coding häufig unterschätzt:
Du betreibst nicht nur deinen eigenen Code.
Moderne Anwendungen bestehen aus einem Ökosystem aus:
- Frameworks
- Libraries
- npm-/PyPI-/Maven-Paketen
- Plugins
- Authentication Libraries
- SDKs
- Datenbanktreibern
- UI-Komponenten
- Build Tools
- Docker Images
- CI/CD Actions
- Cloud Services
Bei einem kleinen Projekt sind diese Abhängigkeiten vielleicht noch überschaubar.
Mit wachsender Anwendung steigt jedoch die Komplexität. Eine Anwendung kann schnell hunderte oder sogar tausende transitive Dependencies enthalten. Muss eine Bibliothek aktualisiert werden, zum Beispiel aufgrund einer veröffentlichten CVE-Schwachstelle, so kann dies sehr schnell anderweitige Abhängigkeiten beeinträchtigen und Aktualisierungen erschweren.
Damit entsteht eine weitere Security-Frage:
Werden diese Komponenten regelmäßig aktualisiert und auf bekannte Schwachstellen geprüft?
Patch Management gehört zur Verantwortung
Eine sichere Anwendung heute ist nicht automatisch eine sichere Anwendung in sechs Monaten.
Neue Schwachstellen werden veröffentlicht. Libraries bekommen Security Fixes. Frameworks ändern ihre Versionen. Plugins werden aktualisiert oder möglicherweise sogar aufgegeben.
Deshalb gehört Patch- und Dependency-Management zum Security Lifecycle einer Anwendung.
Dabei sollte man nicht einfach jedes Update blind installieren.
Ein Update kann:
- Security Fixes enthalten,
- Breaking Changes verursachen,
- APIs verändern,
- andere Dependencies beeinflussen oder
- wiederum neue Schwachstellen einführen.
Hier ist ein kontrollierter Prozess entscheidend.
SemVer hilft – löst das Problem aber nicht
Semantic Versioning – beispielsweise MAJOR.MINOR.PATCH – kann dabei helfen, Änderungen einzuordnen.
Vereinfacht:
PATCH: Bug- und Security-Fixes ohne geplante API-ÄnderungMINOR: neue, kompatible FunktionalitätMAJOR: potenziell inkompatible Änderungen
Aber auch SemVer ist keine Security-Garantie.
Ein Security Fix kann beispielsweise in einer Patch-Version erscheinen. Gleichzeitig kann eine Anwendung bewusst auf einer alten Major-Version eines Frameworks verbleiben.
Dann stellt sich die Frage:
Ist diese Version noch gepflegt und erhält sie weiterhin Security Updates?
Für größere Vibe-Coding-Projekte sollte deshalb nicht nur die Versionsnummer betrachtet werden, sondern auch:
- Wird die Dependency noch maintained?
- Gibt es bekannte CVEs?
- Gibt es verfügbare Security Patches?
- Welche transitive Dependency ist betroffen?
- Gibt es Breaking Changes?
- Wann wurde zuletzt aktualisiert?
- Ist die verwendete Version überhaupt noch supported?
CI/CD: Der vergessene Teil vieler Vibe-Coding-Projekte
Ein weiterer häufiger Schwachpunkt ist die Deployment-Pipeline.
Gerade wenn AI-Agenten schnell neue Features produzieren, sollte nicht jede Änderung direkt und ungeprüft in Produktion gelangen.
Eine professionelle CI/CD Pipeline kann Security Checks automatisiert in den Entwicklungsprozess integrieren.
Zum Beispiel:
Commit → Build → Tests → SAST → Dependency Scan → DAST → Deployment
Dabei können unterschiedliche Verfahren unterschiedliche Probleme erkennen.
SAST
Static Application Security Testing untersucht den Quellcode beziehungsweise die Code-Struktur, ohne die Anwendung zwingend auszuführen.
Damit lassen sich beispielsweise bestimmte problematische Code Patterns oder unsichere Konstruktionen erkennen.
Dependency Scanning / SCA
Software Composition Analysis untersucht verwendete Libraries und Dependencies auf bekannte Schwachstellen.
Das ist gerade bei AI-generiertem Code relevant, weil ein Agent schnell zusätzliche Pakete installiert, um eine Funktion umzusetzen.
DAST
Dynamic Application Security Testing untersucht eine laufende Anwendung aus der Perspektive eines externen Systems. Dadurch können beispielsweise bestimmte Schwachstellen erkannt werden, die sich erst im Verhalten der tatsächlich laufenden Anwendung zeigen.
Doch auch hier zeigen sich oftmals Probleme.
Nämlich Testtiefe vs. Zeit.
Eine CI/CD-Pipeline, welche stundenlang auf DAST-Ergebnisse wartet, ist nicht zumutbar. Zeitgleich können dynamische Scans in wenigen Minuten kaum ernstzunehmende Sicherheitsprobleme finden oder alle Schwachstellenklassen prüfen.
Wichtig: Automatisierung ersetzt keine Security-Verantwortung
SAST, DAST und Dependency Scanning sind wichtige Bausteine.
Sie beantworten aber nicht automatisch die Frage:
„Kann ein Angreifer diese Anwendung als Ganzes missbrauchen?“
Business-Logic-Fehler, komplexe Autorisierungsprobleme oder ungewöhnliche Angriffspfade können automatisierte Tools übersehen.
Deshalb sollten automatisierte Security Checks und professionelle manuelle Tests zusammenspielen, nicht gegeneinander ausgespielt werden.
„Aber mein AI-Agent testet den Code doch“
AI-Agenten können Tests schreiben. Sie können Code analysieren. Sie können Security Scanner ausführen. Und sie können sogar versuchen, Schwachstellen zu finden.
Das ist sehr hilfreich. Aber ein AI-Agent kennt nicht automatisch die tatsächlichen Sicherheitsannahmen deiner Anwendung. Zusätzlich sind die Fähigkeiten eines AI-Agentens erneut abhängig von dem initialen Nutzer-Promt sowie definierten Skills und Tool-Calling-Möglichkeiten.
Er kennt möglicherweise nicht:
- welche Daten besonders sensibel sind,
- welche Rollen miteinander interagieren,
- welche Geschäftsprozesse kritisch sind,
- welche Trust Boundaries existieren,
- welche Angriffswege ein realer Angreifer kombinieren würde.
Automatisiertes Scanning und agentisches Testing können daher eine sehr gute zusätzliche Verteidigungslinie sein.
Sie ersetzen aber nicht automatisch einen professionellen Pentest.
Warum menschliche Pentester auch im AI-Zeitalter wichtig bleiben
Ein professioneller Pentest betrachtet eine Anwendung nicht nur als Sammlung einzelner Codezeilen.
Ein Pentester versucht zu verstehen:
- Wie funktioniert die Anwendung?
- Welche Rollen gibt es?
- Welche Daten sind besonders interessant?
- Wo liegen Trust Boundaries?
- Welche APIs können kombiniert werden?
- Welche Security Controls sind vorhanden?
- Wo kann Business Logic missbraucht werden?
- Welche Angriffsketten entstehen aus mehreren scheinbar kleinen Schwachstellen?
Gerade diese Kombination verschiedener Informationen ist eine der Stärken eines manuellen Pentests. Hinzu kommt die jahrelange Expertise, Branchenkenntnisse und tiefes Wissen auf Abruf – kombiniert mit vertraglichen Rahmenbedingungen und Ethischem Handeln.
Dabei können moderne AI-Werkzeuge den Pentester unterstützen. Ein erfahrener Security Experte kann beispielsweise ein LLM gezielt zur Analyse, zur Hypothesenbildung oder zur Verbesserung von Testfällen einsetzen.
AI ersetzt damit nicht zwingend den Pentester – sie kann den Pentester leistungsfähiger machen.
Lovable, Supabase und ein begrenzter Technologie-Stack
Plattformen wie Lovable verfolgen einen interessanten Ansatz. Statt jedem Entwickler beliebig viele Technologien zu überlassen, wird die Auswahl des Stacks stärker standardisiert.
Das kann erhebliche Vorteile haben.
Wenn wiederkehrend etablierte Technologien, Frameworks und Libraries eingesetzt werden, können:
- Best Practices leichter etabliert werden,
- Integrationen standardisiert werden,
- Security Controls wiederverwendet werden,
- Dokumentation verbessert werden und
- Entwickler schneller produktiv werden.
Je nach Projekt können beispielsweise Technologien aus dem React-/Next.js-Ökosystem, TanStack, Supabase oder etablierte Authentication Libraries zum Einsatz kommen.
Aber auch ein standardisierter Stack macht eine Anwendung nicht automatisch sicher.
Denn die Security hängt weiterhin davon ab, wie diese Komponenten konfiguriert und miteinander verbunden werden.
Eine falsch konfigurierte Datenbank-Policy bleibt falsch – unabhängig davon, wie etabliert die verwendete Plattform ist.
Automated Security ist kein Sicherheitsbeweis
Auch integrierte Security Checks, automatisiertes Code Scanning oder AI-basierte beziehungsweise agentische Pentesting-Lösungen sind deshalb sinnvoll, aber nicht mit einem vollständigen Security Assessment gleichzusetzen.
Solche Systeme können beispielsweise bekannten unsicheren Code erkennen, Abhängigkeiten auf Schwachstellen prüfen, Konfigurationen analysieren oder automatisiert nach bestimmten Angriffsmöglichkeiten suchen. Gerade bei schnell entwickelten Vibe-Coding-Projekten können solche automatisierten Prüfungen wertvolle zusätzliche Sicherheitskontrollen darstellen. Besser als nichts.
Sie beantworten aber nicht zwangsläufig die entscheidende Frage:
Ist diese konkrete Anwendung mit ihrer individuellen Geschäftslogik, ihren Berechtigungen und ihren Datenflüssen tatsächlich sicher?
Ein Scanner kann beispielsweise erkennen, dass eine bestimmte Library veraltet ist. Schwieriger wird es, wenn die eigentliche Schwachstelle aus dem Zusammenspiel mehrerer Komponenten entsteht. Etwa aus Authentication, Rollenmodell, Datenbank-Policies und einer API, die eine vom Client übermittelte ID ungeprüft verwendet.
Auch ein AI-Agent kann bei einem automatisierten Pentest interessante Schwachstellen finden. Das bedeutet jedoch nicht automatisch, dass alle möglichen Angriffspfade, Business-Logic-Probleme oder komplexen Berechtigungskonstellationen abgedeckt wurden.
Das gilt insbesondere dann, wenn eine Plattform zusätzliche Security-Features oder automatisierte Security-Prüfungen als kostengünstiges Add-on anbietet. Ein solches Feature kann eine sinnvolle Ergänzung sein – es ersetzt aber nicht automatisch eine unabhängige, manuelle Sicherheitsprüfung durch erfahrene Pentester.
Entscheidend ist daher nicht, ob eine Plattform behauptet, dass eine Anwendung „secure“ ist oder ob ein Security-Add-on aktiviert wurde. Entscheidend ist, welche Sicherheitsprüfungen tatsächlich durchgeführt wurden, welche Bereiche abgedeckt sind und ob ein unabhängiger Experte versucht hat, die Anwendung aus Sicht eines Angreifers zu kompromittieren.
Insbesondere aus Pflichten der Nachweisführung für ISO 27001, NIS2, DORA oder einfach nur einer Kundenanfrage.
Wann braucht eine Vibe-Coded App einen Pentest?
Je näher eine Anwendung an produktiven Einsatz kommt, desto wichtiger wird eine unabhängige Security-Prüfung.
Besonders sinnvoll ist ein Pentest beispielsweise, wenn:
- personenbezogene Daten verarbeitet werden,
- mehrere Kunden oder Tenants existieren,
- Benutzerrollen und Berechtigungen vorhanden sind,
- Zahlungsfunktionen integriert sind,
- eine öffentliche API existiert,
- Dateien hochgeladen werden können,
- sensible Geschäftsdaten verarbeitet werden,
- die Anwendung öffentlich erreichbar ist,
- regelmäßig neue AI-generierte Features hinzukommen oder
- die Anwendung bereits produktiv eingesetzt wird.
Je größer die Anwendung wird, desto schwieriger wird es außerdem, alle Abhängigkeiten, Änderungen und Security Controls manuell im Blick zu behalten.
Der Pentest ist dann nicht das Gegenteil von Vibe Coding – er ist eine wichtige Qualitätssicherung dafür.
Du weißt nicht, welchen Pentest du brauchst?
Das ist gerade bei Vibe-Coding-Projekten völlig normal.
Vielleicht weißt du sehr genau, was deine Anwendung macht, aber nicht, wie ein Pentest dafür sinnvoll gescoped werden sollte.
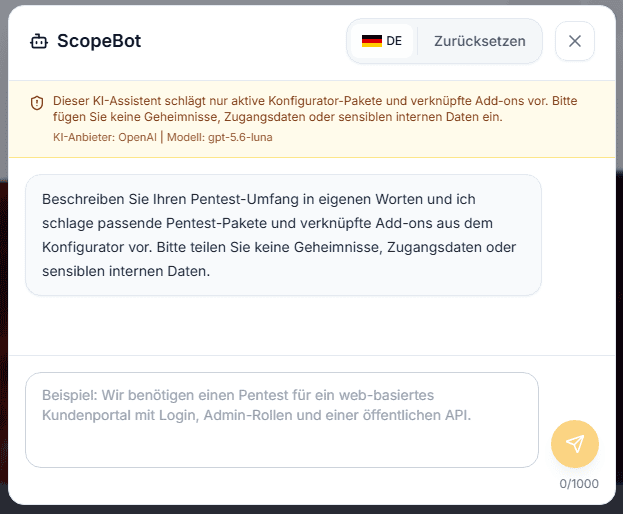
Genau dabei kann unser ScopeBot helfen.
Beschreibe einfach in natürlicher Sprache:
- was deine Anwendung macht,
- welche Benutzer es gibt,
- welche Features vorhanden sind,
- welche Technologien verwendet werden,
- ob APIs existieren,
- ob Dateien hochgeladen werden,
- ob externe Services integriert sind.
Zum Beispiel:
„Ich habe mit Lovable eine SaaS-Anwendung für Handwerksbetriebe gebaut. Benutzer können sich registrieren, Projekte erstellen und Mitarbeiter einladen. Die Anwendung verwendet Supabase und Stripe. Es gibt Admins und normale Benutzer. Kunden können PDFs hochladen. Zusätzlich gibt es eine API für eine mobile App.“
ScopeBot kann daraus ableiten, welche Bereiche für einen Pentest relevant sein könnten. Anschließend kannst du den passenden Umfang über den Pentest-Konfigurator zusammenstellen und dir direkt einen transparenten Überblick über den möglichen Pentest verschaffen.
Vom Vibe Coding zum Pentest in wenigen Schritten
Der Prozess kann sehr einfach aussehen:
1. Anwendung beschreiben
Gib ScopeBot eine grobe Beschreibung deiner Anwendung und ihrer Features.
2. Scope verstehen
ScopeBot hilft dabei, mögliche relevante Pentest-Bereiche zu identifizieren.
3. Pentest konfigurieren
Im Konfigurator kannst du den gewünschten Umfang festlegen und ein individuelles Angebot erstellen. Dauert nur 5 Minuten.
4. Anwendung professionell testen lassen
Unsere OSCP-Experten prüfen die Anwendung manuell und mit professionellen Werkzeugen auf Schwachstellen.
Dabei geht es nicht nur darum, möglichst viele Findings zu produzieren.
Es geht darum, herauszufinden, welche Schwachstellen tatsächlich relevant sind und wie sie sich auf deine Anwendung auswirken.
Du erhältst mehr als eine Liste von Schwachstellen
Ein Pentest sollte nicht mit einer Liste technischer Fehler enden.
Ein professioneller Report hilft dir dabei zu verstehen:
- Was wurde gefunden?
- Warum ist die Schwachstelle relevant?
- Welche Komponente ist betroffen?
- Wie hoch ist das Risiko?
- Wie kann das Problem behoben werden?
- Wie lässt sich verhindern, dass es wieder auftritt?
Gerade beim Vibe Coding kann anschließend wieder dein AI-Agent helfen.
Ein Finding lässt sich beispielsweise in einen konkreten Fix-Prompt übersetzen:
„Behebe die identifizierte Broken-Access-Control-Schwachstelle im Projekt-Endpunkt. Die Berechtigung muss serverseitig anhand des authentifizierten Benutzers und seiner Tenant-Zugehörigkeit geprüft werden. Clientseitig übermittelte IDs dürfen nicht als Vertrauensquelle verwendet werden. Ergänze Regressionstests, die den Zugriff eines Benutzers auf Objekte eines anderen Tenants verhindern. Verändere keine bestehenden Security Controls außerhalb des erforderlichen Scopes.“
Diesen Prompt kannst du anschließend in deinen Agentic-Coding-Workflow übernehmen. Der Agent kann den Code analysieren, die Änderung implementieren und entsprechende Tests ergänzen.
Danach sollte die Änderung erneut geprüft werden.
Damit entsteht ein moderner Security-Workflow:
AI entwickeln lassen → automatisiert prüfen → professionell pentesten → Findings verstehen → AI beim Fix unterstützen → Regression testen → erneut deployen
Security für die neue Generation von Codern
Vibe Coding bedeutet nicht, dass Security unwichtig wird.
Im Gegenteil.
Wenn Softwareentwicklung schneller wird, muss auch Security stärker in den Entwicklungsprozess integriert werden.
Der wichtigste Gedanke ist deshalb nicht:
„AI schreibt unsicheren Code.“
Sondern:
„AI macht es einfacher, sehr schnell sehr viel Code zu produzieren. Deshalb brauchen wir bessere Security-Prozesse, um diesen Code dauerhaft sicher zu betreiben.“
Dazu gehören:
- Security-bewusste Prompts
- sichere Frameworks und Libraries
- Dependency Management
- Patch Management
- SemVer und kontrollierte Updates
- CI/CD
- SAST
- DAST
- Dependency Scanning
- Security Regression Tests
- automatisierte Security Checks
- und unabhängige professionelle Pentests
Jetzt deine Vibe-Coded App absichern
Du hast deine Anwendung mit AI und LLMs gebaut?
Dann musst du nicht erst Security-Experte werden, bevor du einen Pentest starten kannst.
Beschreibe dein Projekt einfach unserem ScopeBot KI-Chat. Er hilft dir dabei, den passenden Pentest für deine Anwendung zu finden. Anschließend kannst du den Umfang online konfigurieren und dein individuelles Angebot erstellen.
Für deinen ersten Pentest erhältst du mit dem Code VIBING26 aktuell 10% Rabatt.
Dein AI-Agent hat deine Anwendung gebaut. Jetzt sorgen wir gemeinsam dafür, dass sie auch sicher ist.